

TypeSafe Jev
0. 写在前面
无人商店值守系统:顾客用微信小程序扫码开门、进店拿货、直接出店,剩下的事交给系统——门禁记录、货架视觉识别、出口称重,再和顾客在小程序里提交的订单做核对。客服后台的每一单,本质上都在回答几个固定问题:
这一单算不算漏付?该不该自动催收?这次开门要不要放行?这条上报该升级给谁?
这类判断有个共同点:答案的取值空间是有限的、事先定义好的。它不是让你写一段文字表达观点,而是在几个确定的选项里选一个、在一把有序的尺子上量一下、或者回答一个是否。
我们一开始的想法和大多数人一样:丢给大模型最省事。一个 Prompt 进去,“请判断这一单属于以下哪种情况,并给出理由”,出来一段挺像样的中文,再用正则或 JSON mode 抠出关键词。跑了几个月,问题很集中:
- 慢。开门风控是实时的,顾客站在门口等,一个 3–8 秒的推理链路直接毁掉体验;
- 贵。订单核对是天然的批量场景,一天几千单,按 token 结账每一单都在烧钱;
- 输出还是散文。哪怕用了 JSON mode,模型仍然倾向于”说清楚”,你不得不写一层解析和兜底,代码里堆满
if (text.contains("漏付")); - 最要命的:它给不出一个可信的数。模型说”疑似漏付”,你拿什么决定是自动催收还是转人工?它没告诉你它有多确定。
我们真正需要的不是”一个更会聊天的模型”,而是一个不聊天、只做判断、并且把”有多确定”一起交出来的东西。这就是 TypeSafe 的 Jev 想解决的问题。
1. 一句话总结
Jev 不是一个小号的大模型,而是一个不生成任何文字、只返回带概率的类型化决策的模型——它把”判断”从自然语言里拿出来,重新塞回类型系统。
它不替代 GPT 或 Claude。写文案、做摘要、和顾客对话,该用 LLM 还是用 LLM。Jev 抢的是另一块地盘:分类、路由、打分、守门——那些代码本来就想 switch 的地方。
LLM :给人和代码都看得懂的文本(主要给人看)Jev :给代码看得懂的类型化决策(不给任何人看)2. Jev 是什么
2.1 名字的来历
TypeSafe AI 于 2026 年 9 月从 stealth 走出,创始人 Diogo Almeida、Sasha Sheng、Erik Gafni,种子轮约 4000 万美元,DCVC 领投。他们把 Jev 称为第一个 System One Model(快思考模型),借的是 Kahneman”系统一 / 系统二”的说法。
有意思的是产品名来自另一个人:William Stanley Jevons。他的论断是”更便宜的资源会导致更多消耗”——言外之意是,当一次判断的成本低到可以忽略,你会开始做多得多的判断。这个定位比”我们要做个更强的模型”诚实得多。
2.2 它和 LLM 的分工边界
选型的第一步不是看谁更强,而是先问:这个任务需要的是”说”,还是”判断”?
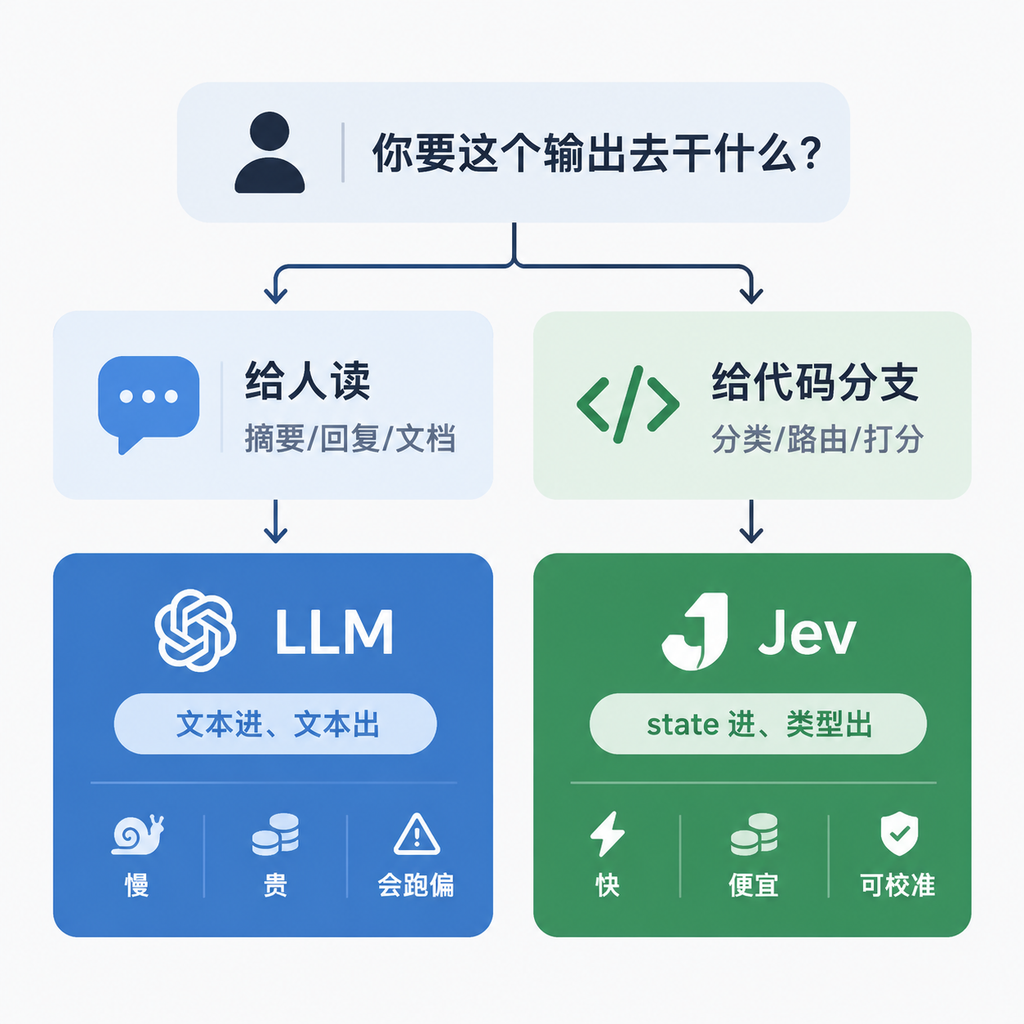
凡是你要写一段代码去解析模型输出的地方,那个位置就是 Jev 该待的地方。
2.3 关键点:它输出的是”校准过的概率”
这是和之前用 LLM 做判断最本质的区别,也是最值得花时间理解的一点。
LLM 在 RLHF 之后有个通病:过度自信。你让它判断一个模棱两可的样本,它也会用同样笃定的语气给结论——因为人类标注员喜欢自信的回答,训练目标就往那个方向偏了。TypeSafe 把这个问题叫 mode dropping:训练过程把”虽然冷门但确实合理”的答案压了下去。
Jev 换了训练目标:RLCD(Reinforcement Learning for Calibrated Decisions),校准的决策。它每个 Choice 和 Score 的答案都附一个 confidence,这个值从整个概率分布的形状推出,不是简单取最高项的概率。官方文档里有个很能说明问题的例子:三个部门里 billing 拿到 0.84 的概率,看起来挺高,但 technical 还留着 0.159 的概率质量——所以给出的 confidence 只有 0.596。这就是”分布不够干净”的诚实表达。
对我们这种系统意味着什么?
高 confidence → 代码直接执行中 confidence → 排队进人工复核队列低 confidence → 强制转人工,或者干脆不下结论阈值不该是拍脑袋的常数,而应该跟着”判断错一次的代价”走。 另外必须说清:校准是群体意义上的性质,不是单次调用正确的保证。 它说的是”当模型说 80% 时,长期看大约 80% 是对的”,而不是”这一次它一定对”。所以人工兜底通道该留还得留。
3. 三种原语:Noul / Choice / Score
整个 API 只要理解三个原语就完了,没有第四种。
3.1 Noul:一个是非题
Noul 回答一个 yes/no 问题,返回 0 到 1 之间的概率,即”是”的概率。它没有单独的 confidence 字段——这个概率本身就是置信度。
{ "is_missing_item": { "type": "noul", "instructions": "是否有商品被带离门店但没有结算?", "criteria": { "true": "识别到的商品里有订单未包含的条目", "false": "识别结果没有超出订单范围" } }}返回
{ "is_missing_item": { "type": "noul", "noul": 0.87 }}criteria 可选,但我建议每次都写上。它能显著减少歧义:我们问”是否漏付”,到底指”有商品没结算”,还是”实付金额小于应付金额”?把 true / false 各自的边界写清楚,输出会稳定很多。
Noul 有个读法上的坑:0.5 附近不是”中等”,而是”说不清”,表示是/否各占一半、模型在告诉你这个判断没依据。我们的做法是严格区分”偏否”和”没有结论”——< 0.2 才算偏否,0.2–0.8 之间一律当”证据不足”处理,直接走人工。
3.2 Choice:从你定义的选项里选一个
返回选中项 + 完整概率分布 + confidence。最多 255 个选项,至少 2 个。
{ "followup_channel": { "type": "choice", "instructions": "客服应该走哪个处理通道?", "criteria": { "auto_close": "直接归档,不打扰顾客", "auto_notify": "小程序内自动推送补款提醒", "manual_contact": "人工联系顾客核对", "to_supervisor": "升级给值班主管复核" } }}返回:
{ "followup_channel": { "type": "choice", "choice": "auto_notify", "probabilities": { "auto_close": 0.08, "auto_notify": 0.71, "manual_contact": 0.18, "to_supervisor": 0.03 }, "confidence": 0.64 }}有个实践约定值得说:选项 id 用程序能直接 switch 的英文短键(auto_notify),说明写成人话给模型看。id 本身不参与推理——官方明确说了,questions 的 key 不会送进模型、只用于回传匹配,所以别把语义塞进 id 里指望它起作用。
注意上面这个例子:auto_notify 拿了 0.71 的最高概率,但 confidence 只有 0.64,因为 manual_contact 还留着 0.18。对我们是”应该进人工队列看一眼”的信号——催收这件事,错一次的代价是顾客投诉。
3.3 Score:在你定义的有序尺子上量一下
把 state 放到你定义的有序档位上,至少 2 档、最多 10 档。
{ "dispute_risk": { "type": "score", "instructions": "如果直接自动催收,引发顾客反驳或差评的风险有多高?", "criteria": [ "低,证据充分,顾客通常认账", "中,存在争议空间", "高,很可能引发投诉" ] }}返回:
{ "dispute_risk": { "type": "score", "score": 1.05, "legend": { "0": "低,证据充分,顾客通常认账", "1": "中,存在争议空间", "2": "高,很可能引发投诉" }, "probabilities": { "0": 0.05, "1": 0.85, "2": 0.10 }, "confidence": 0.80 }}最重要的一点:score: 1.05 是个正常的返回值。 它是按概率加权算出的期望值,可以落在两个档位之间。官方专门提醒:不要把这个小数插值回一个”看起来更精确的量级”。1.05 的意思是”稳稳地在中档、略微偏高档”,它不是 1 到 2 之间的连续刻度。想通这点,就不会再纠结”为什么不是整数”。
3.4 三种原语对照
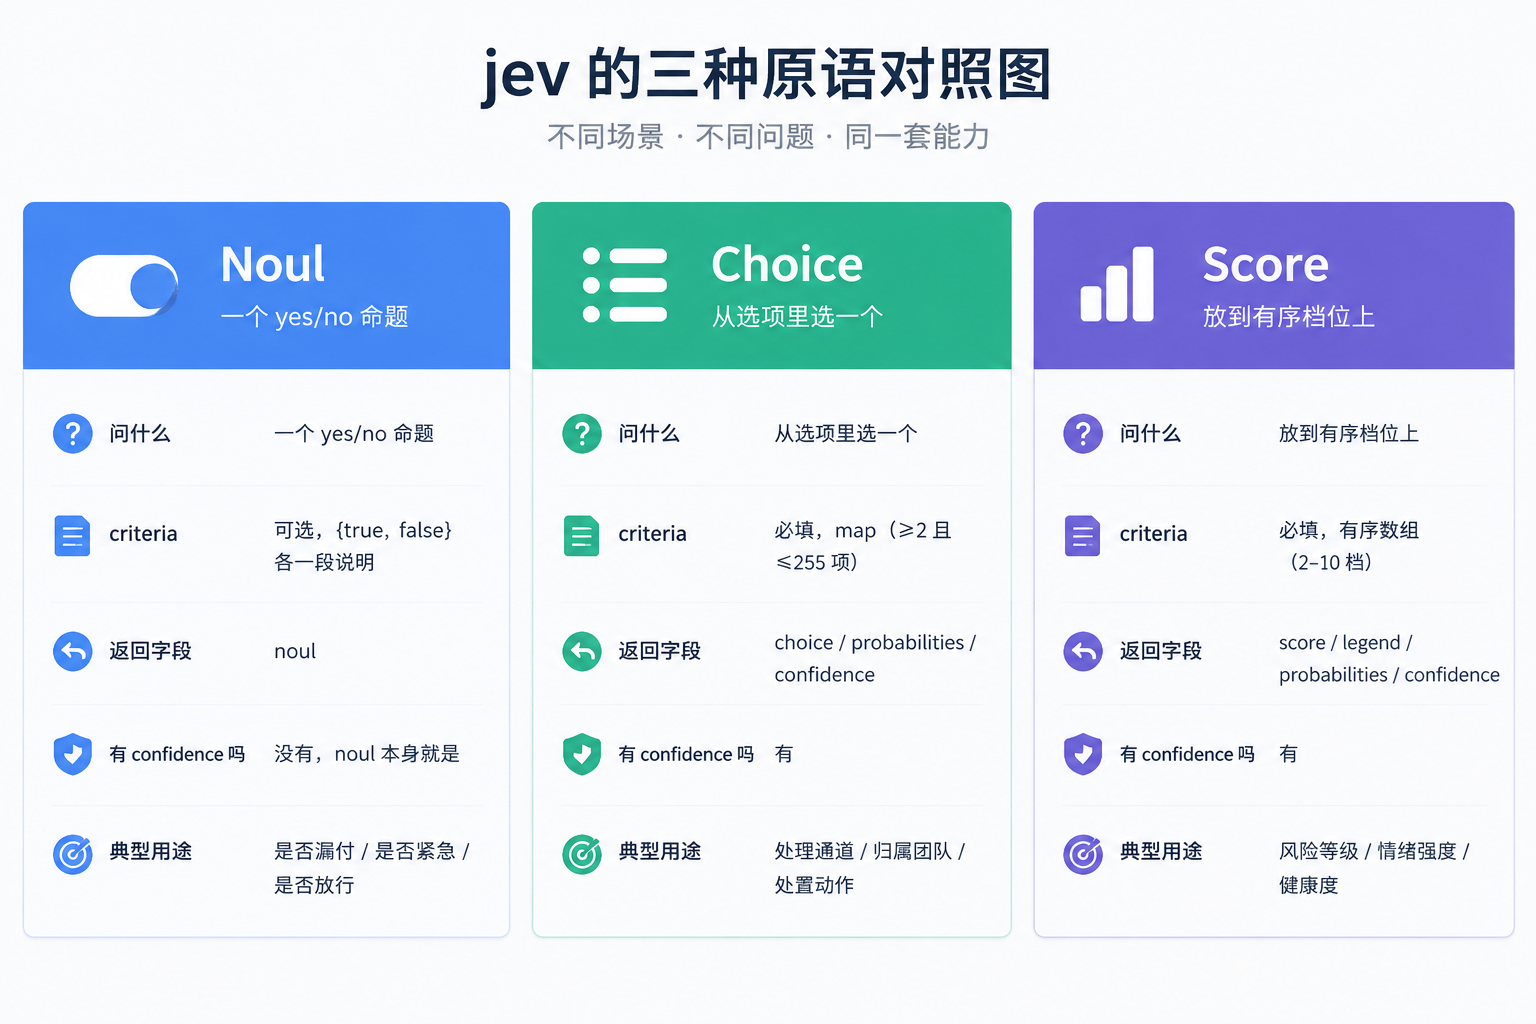
选型时反过来想更顺:代码里要 switch 一句话就选 Choice,要 if 一个条件就选 Noul,要跟阈值比大小就选 Score。
4. 一次调用的完整形状
4.1 端点与请求
整个 API 只有一个端点,请求体只有三个顶层字段:
POST https://api.typesafe.ai/v1/systemoneAuthorization: Bearer <API_KEY>Content-Type: application/json| 字段 | 类型 | 必填 | 说明 |
|---|---|---|---|
state | string | object | array | 是 | 待判断的内容 |
model | string | 是 | 写 jev-latest 就行 |
questions | map<string, Question> | 是 | 问题表,key 随你起 |
state 支持三种形态,这点很关键:
string → 一段客服消息、一条上报文本object → 已经组装好的 JSON 状态(订单、识别结果、事件序列)array → 多条记录,比如一整个会话、一批日志后端的状态对象可以近乎直接地喂进去,不用为了”让模型读懂”再拼一段提示词。一个完整的请求大概长这样:
{ "model": "jev-latest", "state": { "order": { "order_id": "A1937", "declared_items": ["农夫山泉550ml x2", "卫龙辣条 x1", "元气森林白桃 x1"], "submitted_amount_cny": 15.0, "payment": "已付款(微信支付)" }, "recognition": { "source": "货架视觉 + 出口称重", "detected_items": [ { "sku": "农夫山泉550ml", "qty": 2, "price_cny": 2.0 }, { "sku": "卫龙辣条", "qty": 1, "price_cny": 5.0 }, { "sku": "元气森林白桃", "qty": 1, "price_cny": 6.0 }, { "sku": "脆脆鲨威化", "qty": 1, "price_cny": 8.0 } ], "expected_total_cny": 23.0, "vision_confidence": 0.71, "weight_delta_grams": -35 }, "computed_by_backend": { "amount_gap_cny": 8.0, "item_count_gap": 1 }, "events": [ "15:47 顾客离店前折返,A门重新开启 1 次", "15:48 出口称重差值与视觉识别结果相差约 35 克" ] }, "questions": { "verdict": { "type": "choice", "instructions": "...", "criteria": { "...": "..." } }, "is_missing_item": { "type": "noul", "instructions": "..." }, "dispute_risk": { "type": "score", "instructions": "...", "criteria": ["...", "...", "..."] } }}注意 computed_by_backend 这个字段。它是我们自己加的,不是 API 的一部分,但可能是全文最重要的一条实践约定。
4.2 响应
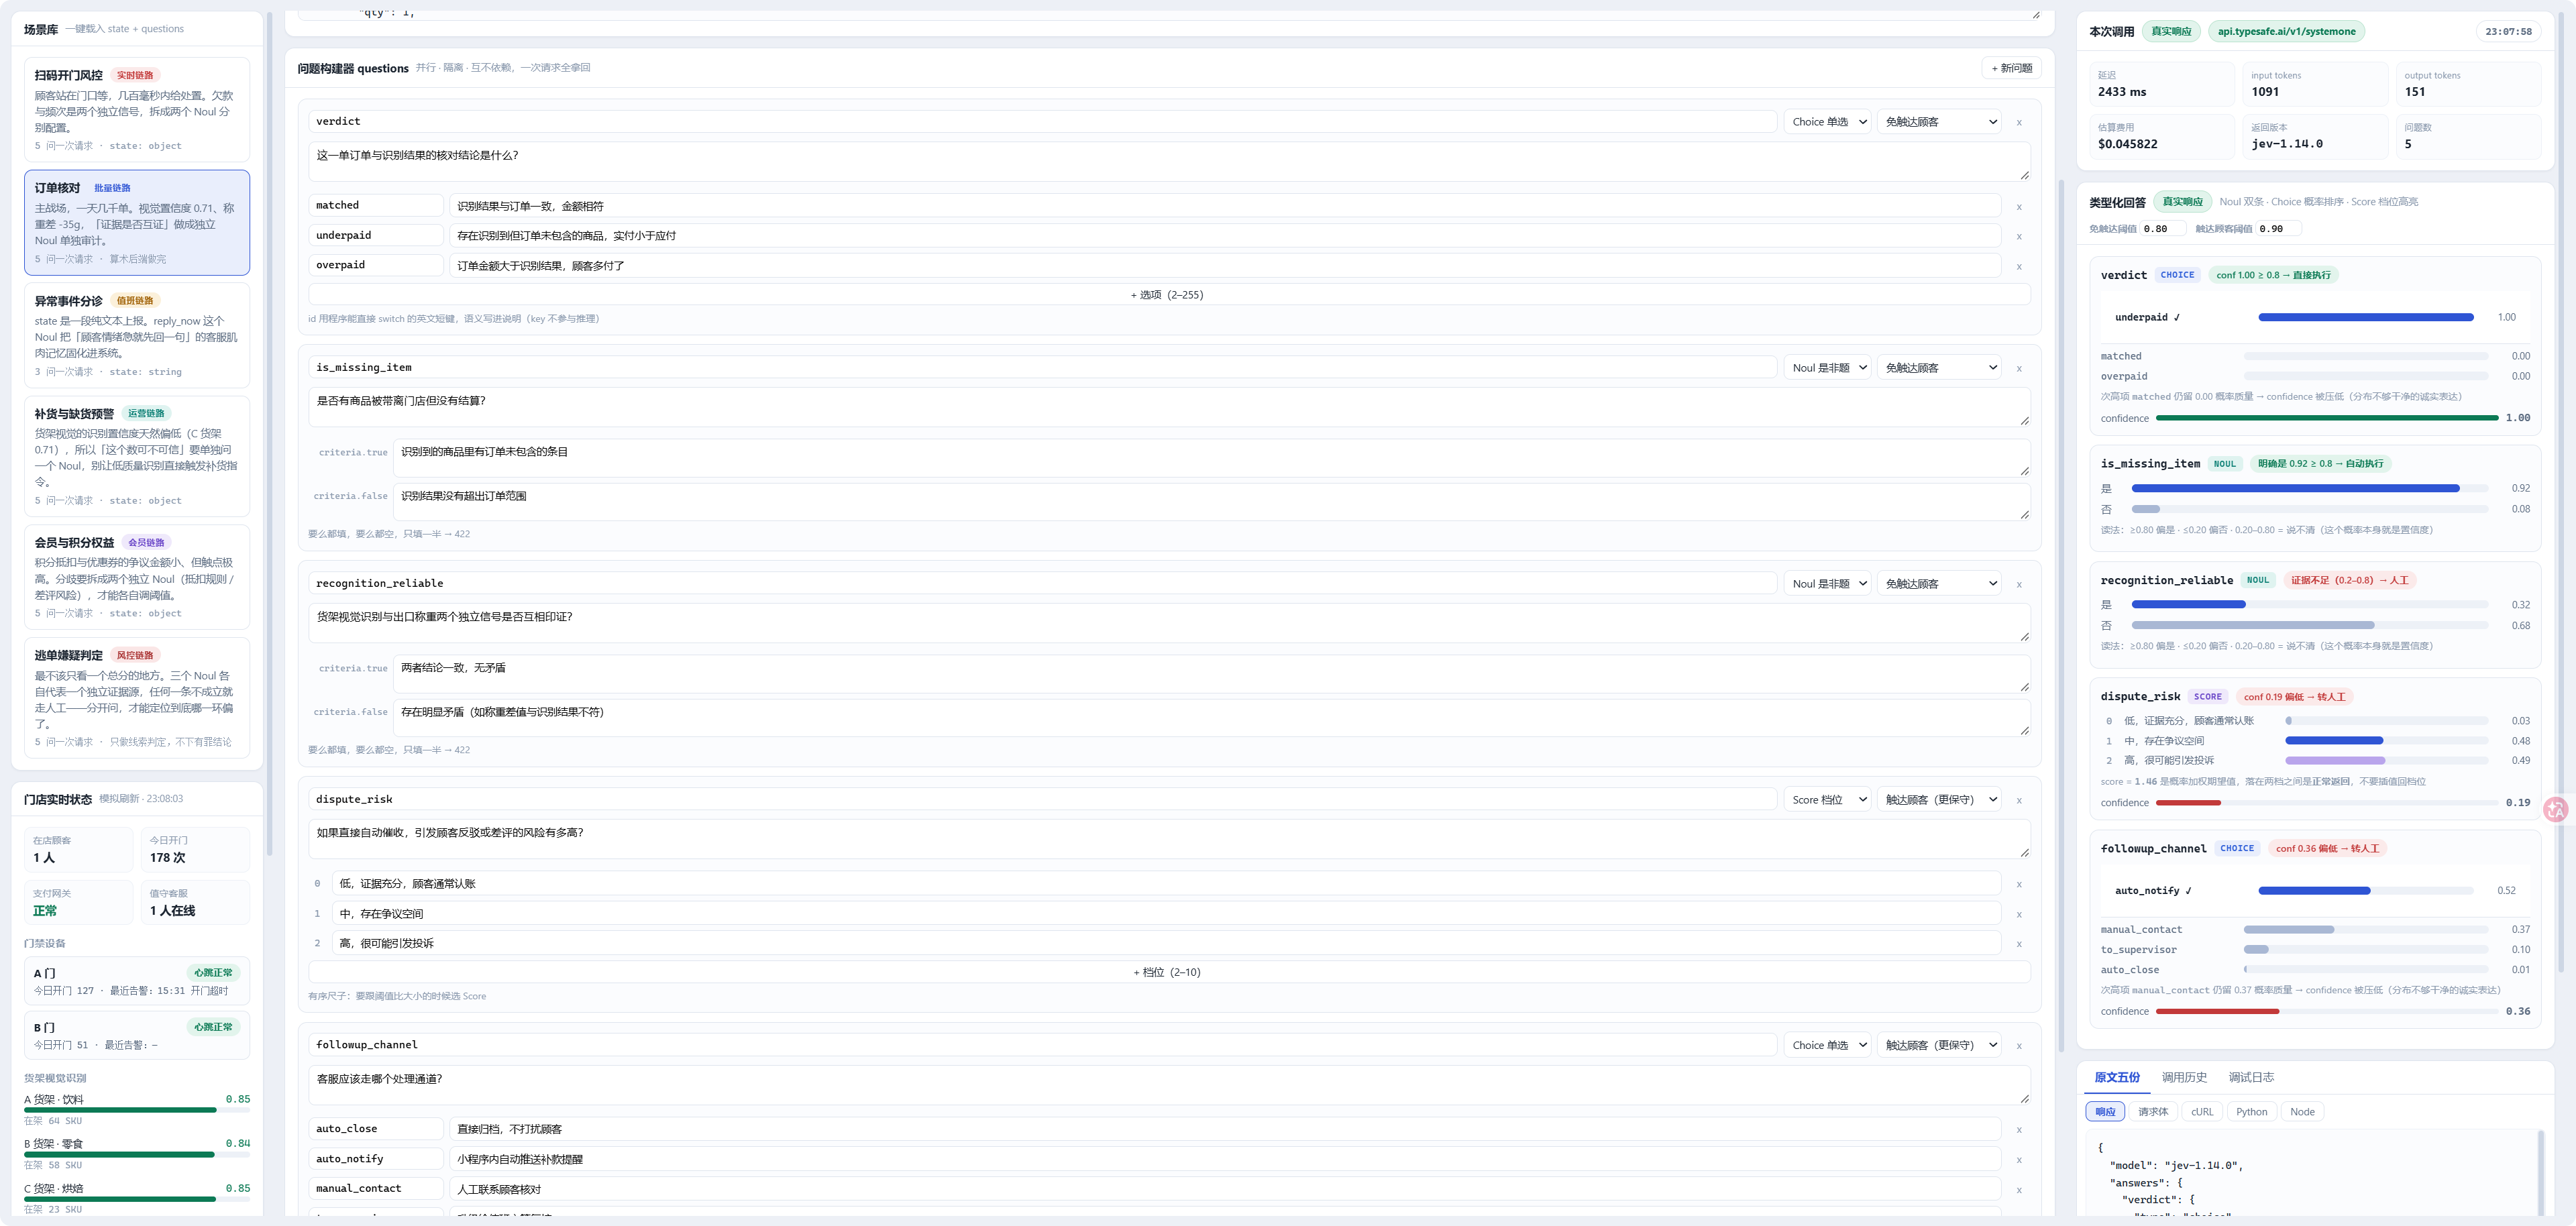
{ "model": "jev-1.13.0", "answers": { "verdict": { "type": "choice", "choice": "underpaid", "probabilities": { "matched": 0.06, "underpaid": 0.74, "overpaid": 0.20 }, "confidence": 0.59 }, "is_missing_item": { "type": "noul", "noul": 0.91 }, "dispute_risk": { "type": "score", "score": 1.05, "legend": { "0": "...", "1": "...", "2": "..." }, "probabilities": { "0": 0.05, "1": 0.85, "2": 0.10 }, "confidence": 0.80 } }, "usage": { "input_tokens": 318, "output_tokens": 34 }}三个细节:model 返回的是具体版本号(jev-1.13.0),不是你请求的别名,日志里存这个出问题才好对齐;answers 的 key 和请求里的 questions 完全一致;output_tokens 很小(这里 34),因为输出本来就不是文本,就是几个数。
4.3 并行与隔离:一个请求里问完所有想问的
官方说得很直接:同一请求里的所有问题,对同一份 state 并行执行、互相隔离、彼此不条件依赖。
一份 state │ ├──► verdict ┐ ├──► followup_channel ├── 并行、互不依赖 ├──► is_missing_item │ 加问题几乎不增加延迟 └──► dispute_risk ┘这条特性直接改变了我们的调用习惯:把所有想问的问题一次性放进 questions,一次请求全拿回来。我们订单核对一单只发一次请求、里面 5 个问题,这是延迟能压下来的主要原因。用 LLM 做不到——要么写一个巨大的 Prompt 让它一次吐结构化输出(互相污染,一个问错全错),要么串行调三次(延迟乘三)。
4.4 错误处理
| 状态码 | 含义 | 我们的处理 |
|---|---|---|
401 | Key 缺失或无效 | 告警,检查 Authorization 头 |
422 | 请求体校验失败 | 告警并打日志,通常是 question 构造有 bug |
429 | 超过速率限制 | 指数退避 + 抖动重试 |
529 | 上游过载 | 同上,退避后重试 |
422 是开发期最常遇到的,官方给的典型原因记下来能省很多时间:
Choice 的选项少于 2 个Score 的档位不在 2–10 之间Noul 的 criteria 只填了 true 或只填了 false(要么都不填,要么填满)questions 为空所以我们在调试台里内置了一套请求发出前的本地校验(见第 6 节),把 422 拦在本地,不浪费一次网络往返。
5. 接进无人商店值守系统
5.1 三条落地约定
约定一:算术一律在后端做完,再放进 state
最容易犯的错。我们一开始 state 里放的是原始数据——订单金额、识别金额、商品列表——然后问模型”实付金额是否小于应付金额”。
问题在于:这是它在做算术,不是在判断。 数字一多就容易错,而金额要精确到分,错一分钱都是事故。
改法是把 state 分成两段,算好的结论和原始证据分开:
state├── 原始证据(给模型理解上下文)│ ├── order.declared_items│ └── recognition.detected_items└── computed_by_backend(后端算好的结论) ├── amount_gap_cny: 8.0 └── item_count_gap: 1后端用 BigDecimal 算准再放进去,模型的活儿就变成在给定证据和结论上做判断——这是它擅长的。这一改,输出稳定性肉眼可见地提升。
约定二:别问”为什么”,把理由拆成独立的 Noul / Choice
Jev 不生成解释文本,第一次用的人很容易想”逼”它说理由。别这么干。 正确做法是把”为什么”拆成一组能被单独回答的子判断:
✗ 无效问法:请说明这一单为什么被判定为漏付
✓ 有效问法: is_missing_item (noul) 是否有商品被带离但没有结算? recognition_reliable (noul) 视觉识别与称重结果是否互相印证? dispute_risk (score) 直接催收引发投诉的风险有多高?好处是每个子答案都是可独立入日志、可独立告警、可独立调参的信号。出了误判,你能定位到具体哪一环判断偏了,而不是对着一整段”理由”发愁。
约定三:confidence 决定通道,阈值跟代价走
不要用同一个阈值处理所有问题。我们的实际配置大致是:
| 场景 | 动作性质 | 高 confidence | 中 | 低 |
|---|---|---|---|---|
| 订单核对 | 自动结单(不影响顾客) | 直接执行 | 抽样复核 | 转人工 |
| 订单核对 | 自动催收(会触达顾客) | 保守执行 | 强制人工 | 强制人工 |
| 开门风控 | 直接放行 | 直接放行 | 带提示放行 | 转人工确认 |
核心原则:错误的代价越大,中低 confidence 越应该往人工那边推。 催收一旦推错,顾客的体感是”我被当成小偷了”,这个代价远高于客服多看一眼的成本。
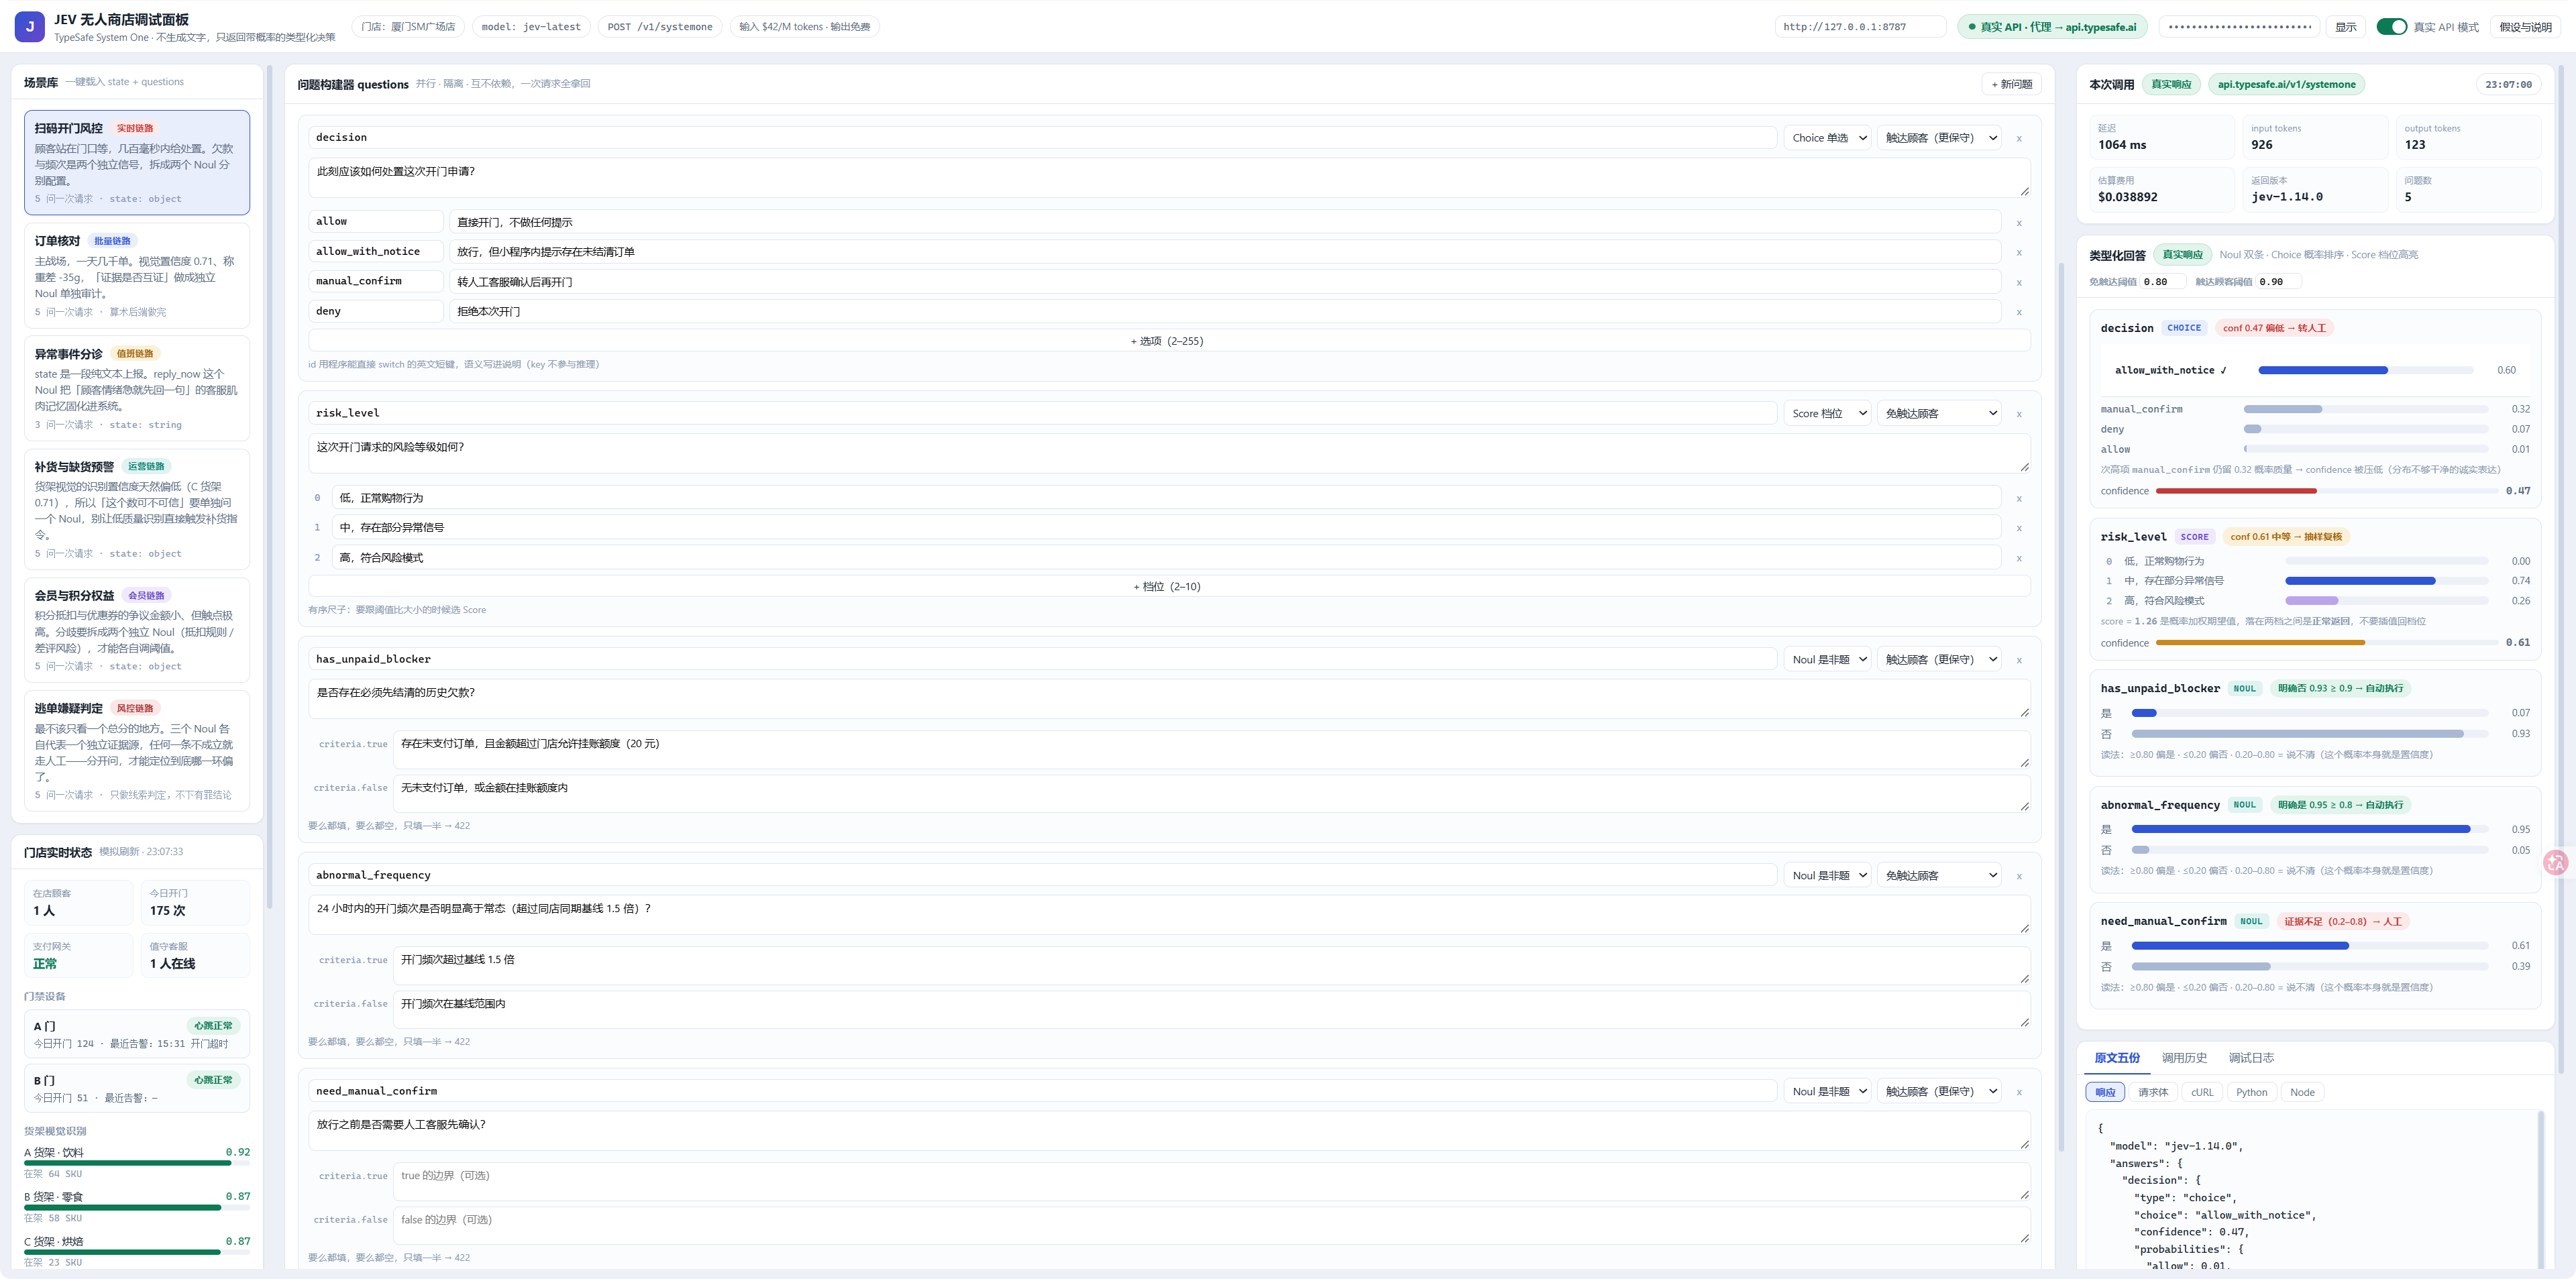
5.2 场景一:扫码开门风控(实时链路)
延迟最敏感的场景。顾客扫码后站门口等,我们要在几百毫秒内给出处置。
{ "request": { "channel": "微信小程序扫码开门", "device_heartbeat_ok": true }, "member": { "realname_verified": true, "register_days": 46, "completed_orders": 27, "chargeback_count": 0, "unpaid_orders": 1, "unpaid_amount_cny": 18.5, "blacklist_hit": false }, "recent_behavior": { "open_requests_24h": 9, "successful_entries_24h": 7, "unusual_events": [ "13:26 离店时订单 A1902 未完成支付,欠款 18.5 元", "15:36 刚离店,5 分钟后再次申请开门" ] }, "context": { "staff_on_duty": true, "waiting_queue": 0, "weather": "雨" }}5 个问题,一次请求:
| id | 类型 | 问题 |
|---|---|---|
decision | choice | 此刻应该如何处置这次开门申请?(allow / allow_with_notice / manual_confirm / deny) |
risk_level | score | 这次开门请求的风险等级如何?(低 / 中 / 高) |
has_unpaid_blocker | noul | 是否存在必须先结清的历史欠款? |
abnormal_frequency | noul | 24 小时内的开门频次是否明显高于常态? |
need_manual_confirm | noul | 放行之前是否需要人工客服先确认? |
这段 state 里埋着个好案例:会员有 18.5 元欠款(13:26 那单),15:36 刚离店、5 分钟后又要进来。“欠款”和”刚离店又进店”是两个独立信号,处置策略不同——前者是钱的问题,后者是行为异常的问题。拆成两个 Noul 就能分别配置:欠款在额度内可以放行+提示,频次异常则必须转人工。
另外,has_unpaid_blocker 的 criteria 我们写的是”存在未支付订单且金额超过门店允许挂账的额度”。这个”额度”是我们自己的业务规则,写进 criteria 之后,模型是在我们的规则下判断,而不是自己猜什么叫”欠款”。把业务规则写进 criteria,是让输出可解释的关键手段。
5.3 场景二:订单核对(批量链路)
主战场,量最大的场景。这里补一个设计上的点:我们把”证据链的互相印证”也做成了一个独立问题。 上面 4.1 的 state 里,视觉识别本身只有 0.71 的置信度,而且称重差值和视觉结果对不上(差 35 克)。我们不是把这些数丢给模型让它自己感受,而是显式构造一个 Noul 去问它”两个独立信号是否互相印证”。这样”证据是否充分”就成一个能被单独审计的信号——当它返回 0.4 的时候,我们知道这一单该转人工,跟它最终判定是漏付还是多付无关。
5.4 场景三:异常事件分诊(值班链路)
这个场景的 state 是纯文本,是最”轻”的用法:
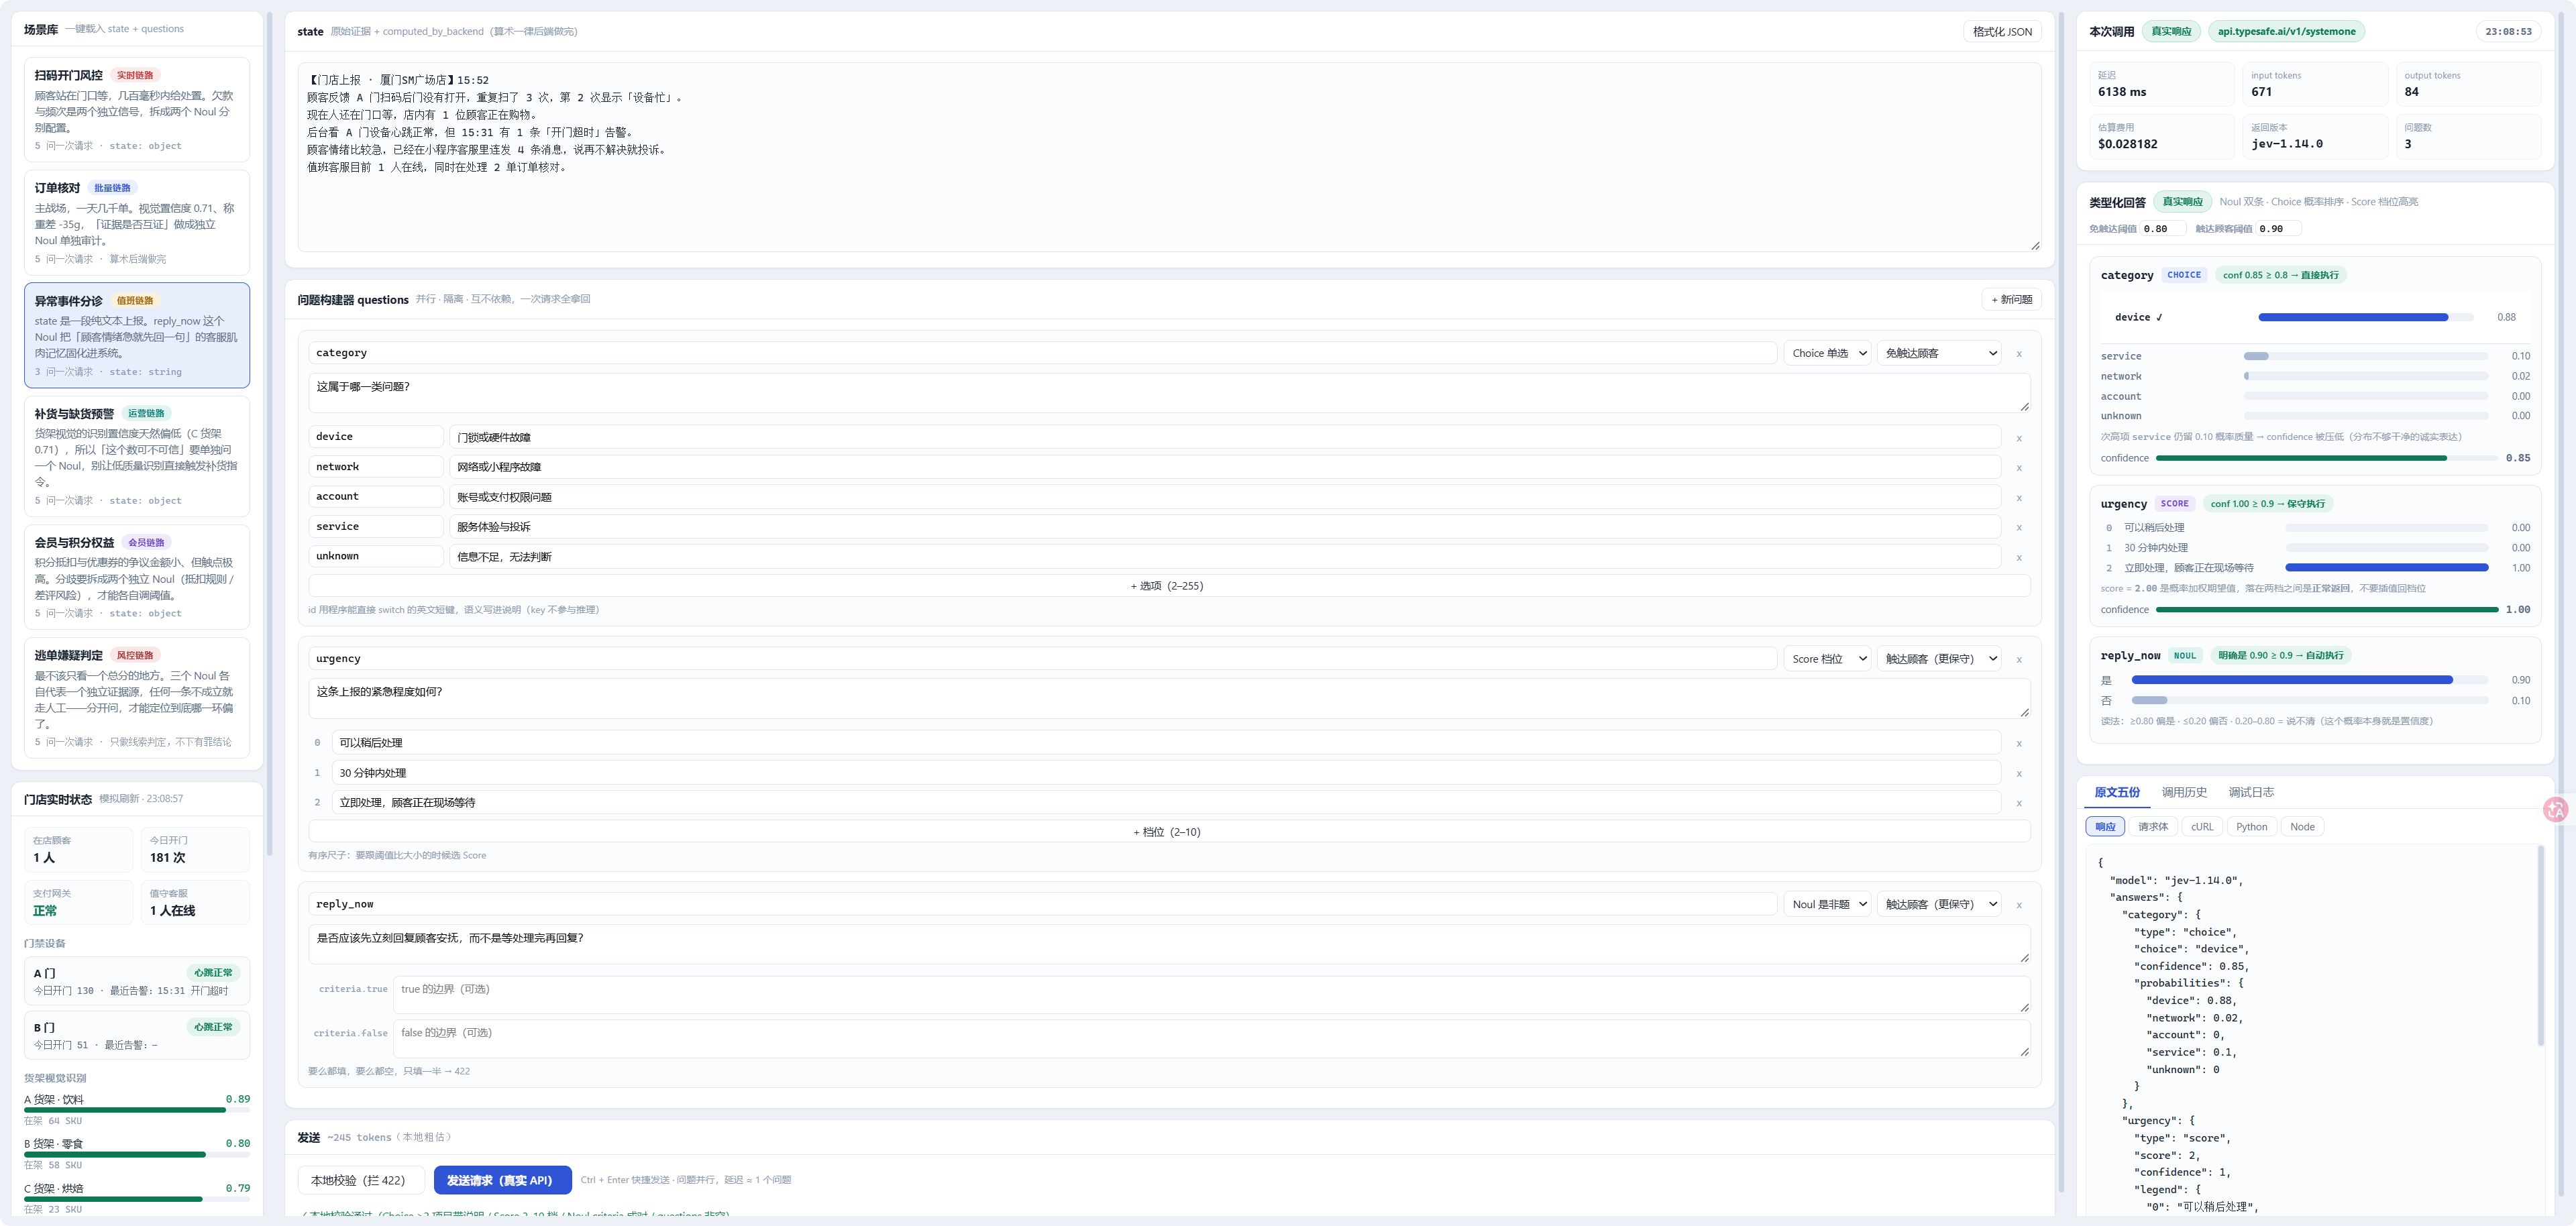
【门店上报 · 厦门SM广场店】15:52顾客反馈 A 门扫码后门没有打开,重复扫了 3 次,第 2 次显示「设备忙」。现在人还在门口等,店内有 1 位顾客正在购物。后台看 A 门设备心跳正常,但 15:31 有一条「开门超时」告警。顾客情绪比较急,已经在小程序客服里连发 4 条消息,说再不解决就投诉。值班客服目前 1 人在线,同时在处理 2 单订单核对。问题设计里我最喜欢这一个:
reply_now (noul):是否应该先立刻回复顾客安抚,而不是等处理完再回复?这是典型的”信息都在字面里、但需要判断”的问题。人类客服看这段文字会立刻回一句”我在,马上帮您看”,但纯规则系统不会——规则里没有”顾客情绪急就先回一句”这条。做成 Noul,等于把客服的肌肉记忆固化进了系统。
6. 本地调试台
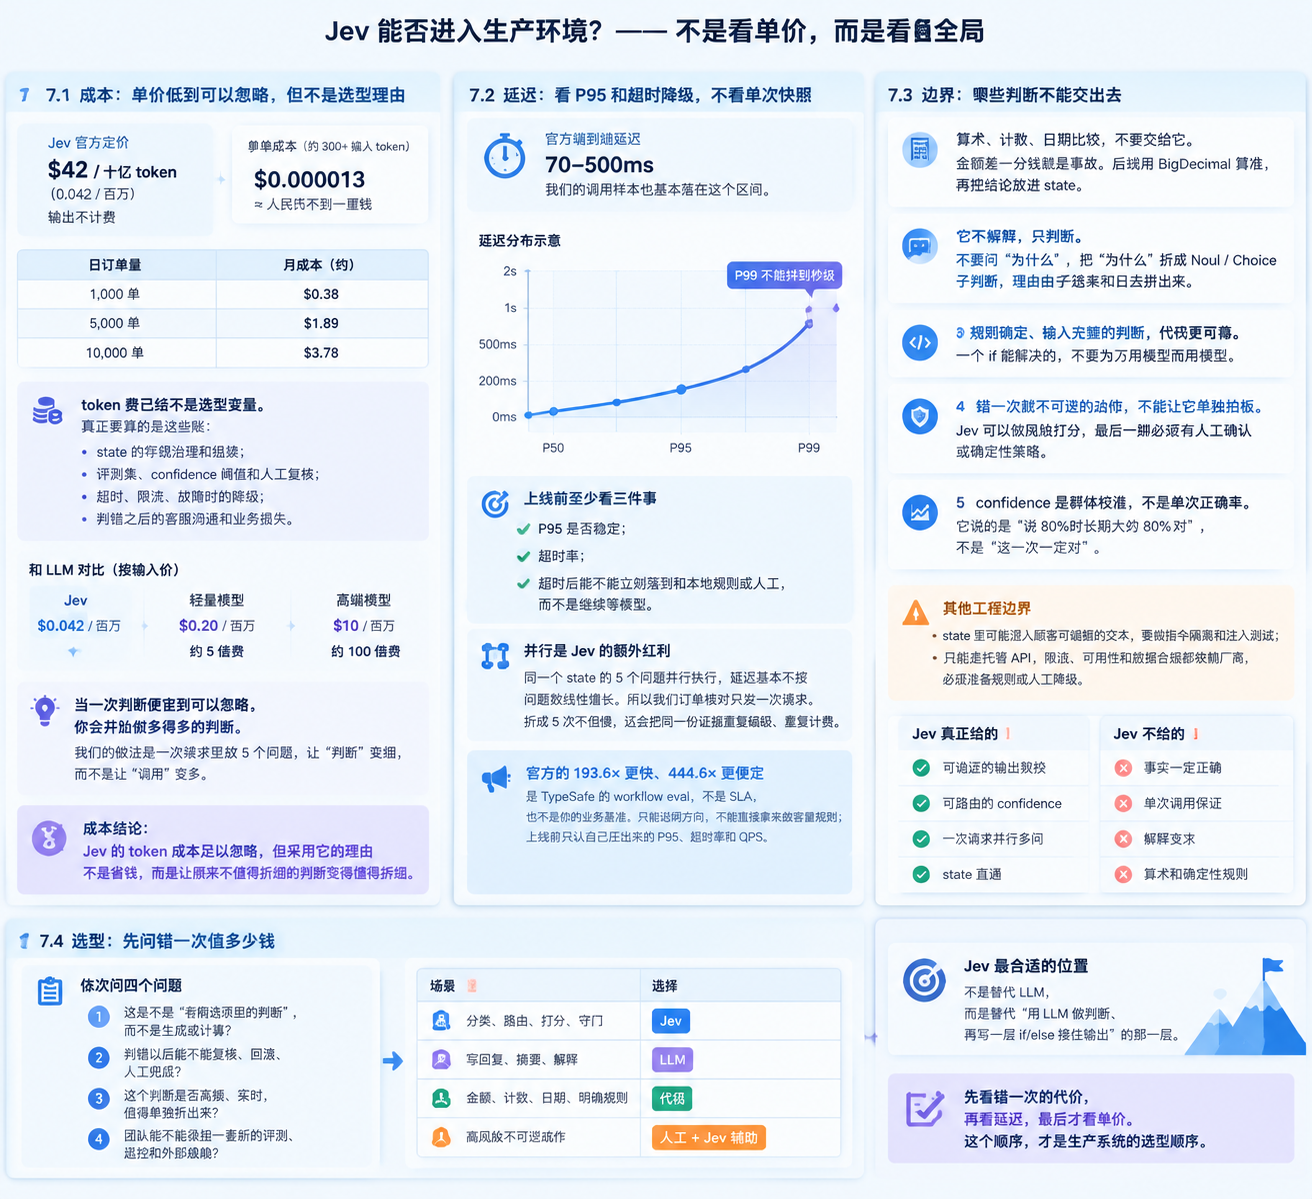
7. 成本、延迟与边界
8. 总结
回头看,Jev 给我们带来的最大变化不是”省了钱”,而是一个思维上的切换:
以前:把一个判断问题,翻译成一句自然语言,丢给模型, 再把模型吐出来的自然语言,翻译回代码能用的东西。
现在:把一个判断问题,直接写成类型定义, 模型返回的就是类型。以前中间那两次翻译,是我们所有麻烦的来源——提示词越写越长,解析层越堆越厚,出了错还说不清是模型的错还是解析的错。Jev 把这两层翻译直接删掉了。
所以选型建议就一句话:
凡是你要写正则或 JSON 解析去读模型输出的地方,换成 Jev;凡是你要读一段文字给顾客看的地方,继续用 LLM。
两者不是替代关系,是分工关系:
顾客消息进来 │ ├──► Jev :这是哪一类?紧急吗?该给谁?(类型化,毫秒级) └──► LLM :帮顾客写一段安抚的回复(文本,秒级)最后提醒一句:别被”零幻觉”和”193 倍”这类宣传话术带着跑。 它真正的价值在于输出形状可信任、不确定性能被量化——这两点已足够改变一个后端系统的写法。至于它到底快多少、便宜多少,答案是:拿你自己的 state 去测。
参考资料
TypeSafe Primitives(Noul / Choice / Score)
本文涉及的相关笔记:[[Spring Boot整合MCP实现数据库查询]]、[[Skills 在 Spring Boot 中的应用]]、[[Dify+DeepSeek]]、[[Kafka 与 RabbitMQ 怎么选]]